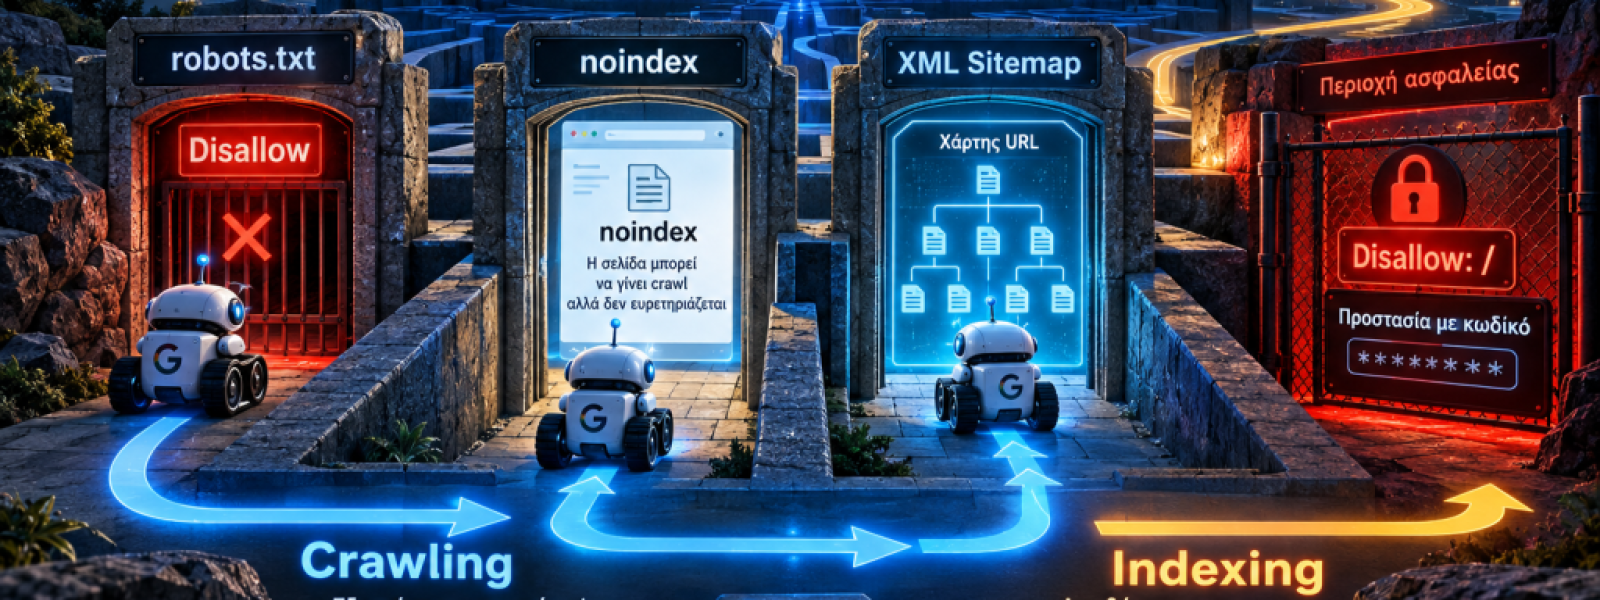
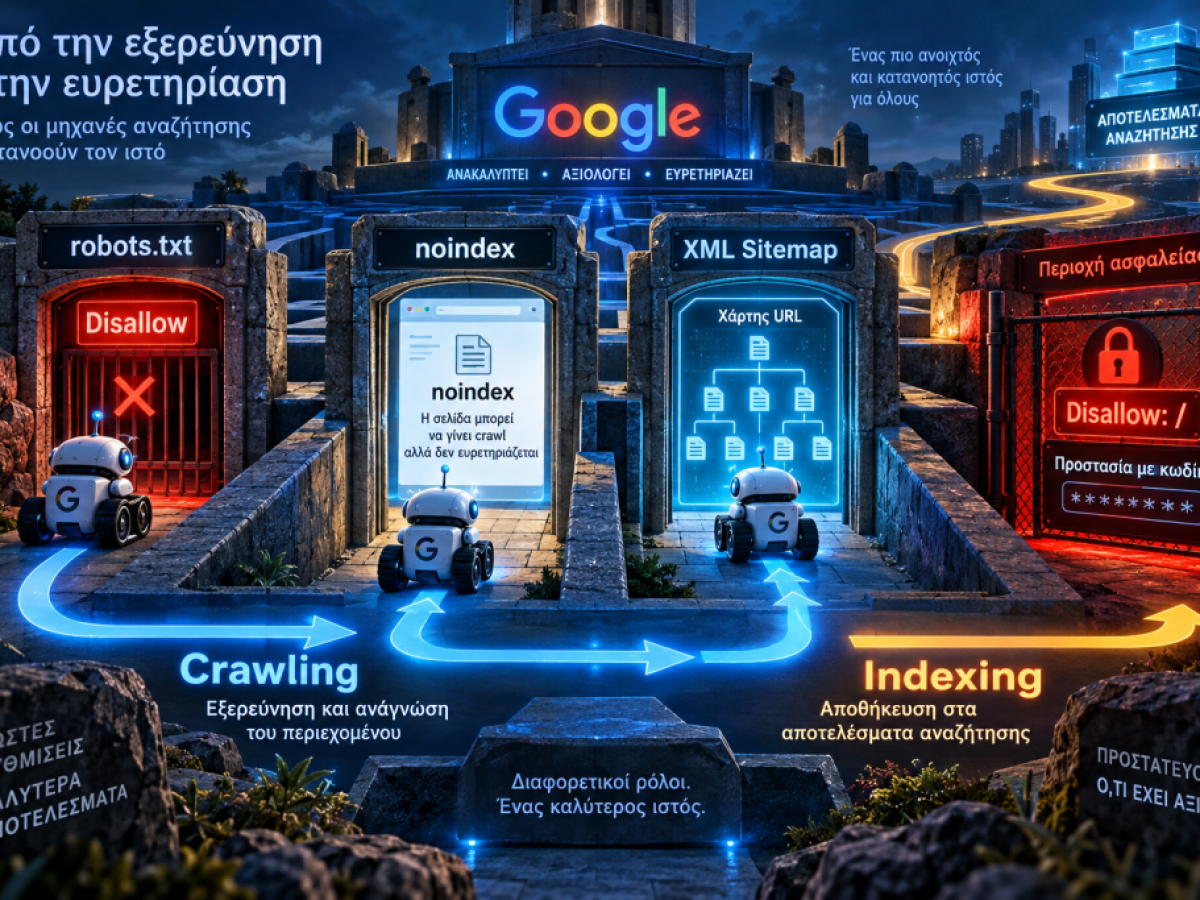
Η σωστή τεχνική βάση είναι απαραίτητη για κάθε ιστοσελίδα που θέλει να εμφανίζεται σωστά στη Google. Ακόμη και ένα site με ποιοτικό περιεχόμενο, σωστούς τίτλους και καλή σχεδίαση μπορεί να αντιμετωπίσει προβλήματα αν οι μηχανές αναζήτησης δεν μπορούν να επισκεφθούν, να κατανοήσουν ή να καταγράψουν τις σελίδες του. Τα robots.txt, noindex και XML Sitemap έχουν διαφορετικό ρόλο και η σωστή χρήση τους αποφεύγει αρκετά συνηθισμένα λάθη.
Το robots.txt ελέγχει το crawling
Το robots.txt είναι ένα απλό αρχείο κειμένου που βρίσκεται στη ρίζα ενός domain, για παράδειγμα στη διεύθυνση example.gr/robots.txt. Περιέχει οδηγίες προς τους crawlers σχετικά με τα URLs ή τα paths που μπορούν ή δεν μπορούν να ζητήσουν.
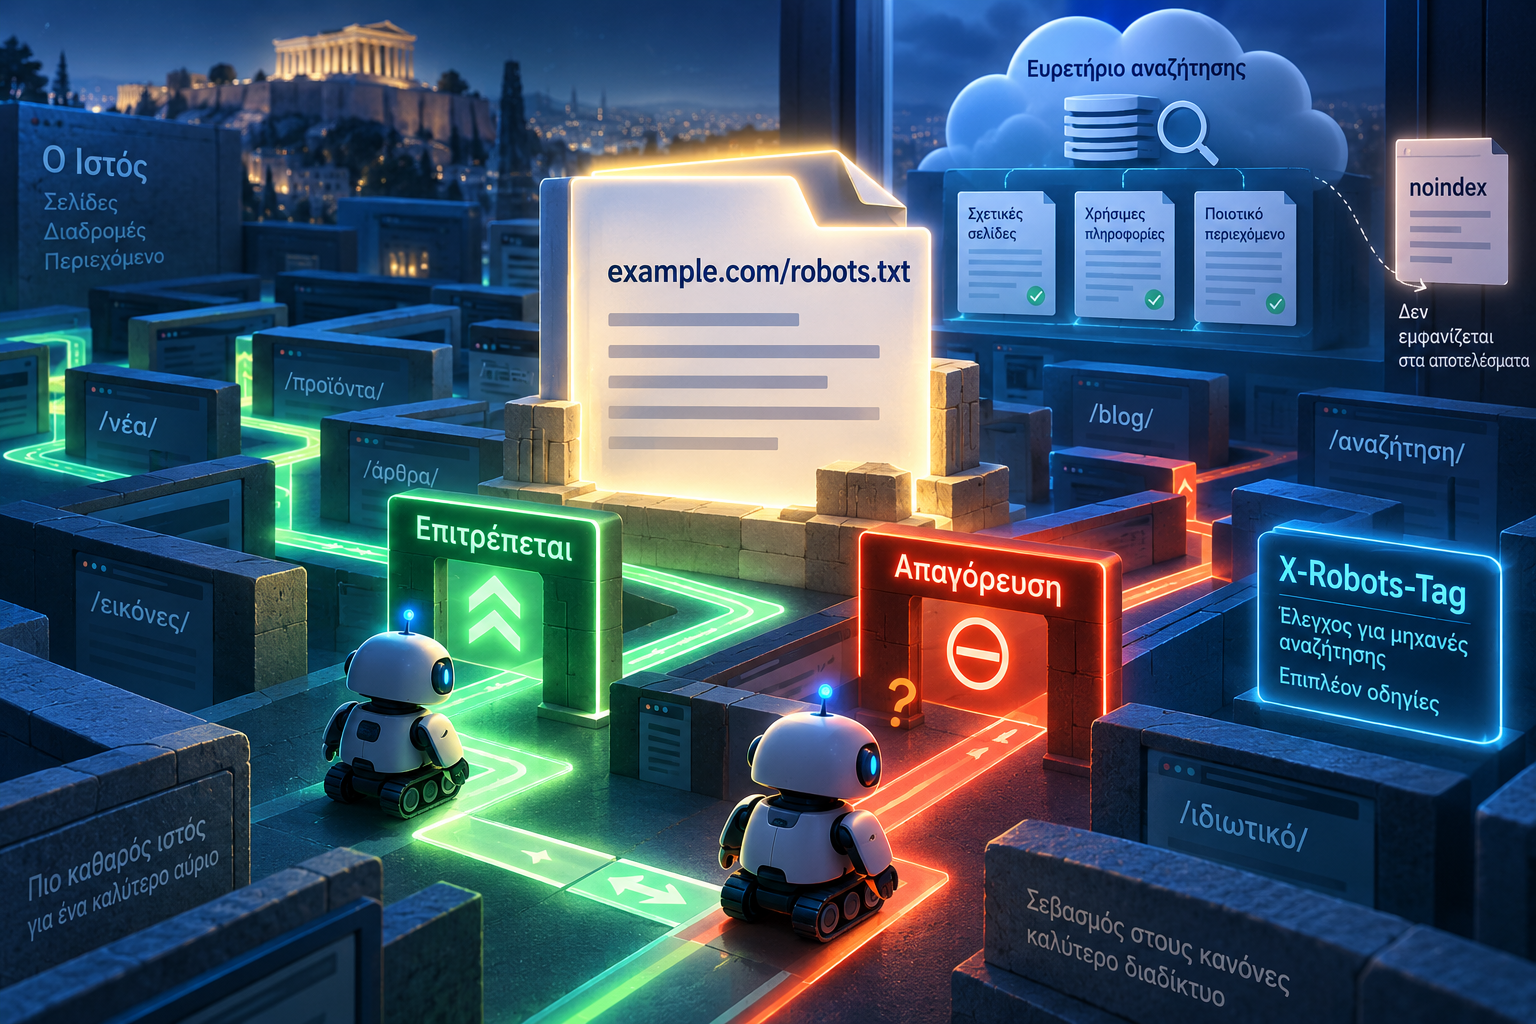
Ένα συνηθισμένο παράδειγμα σε WordPress μπορεί να περιλαμβάνει αποκλεισμό του φακέλου διαχείρισης, αλλά να επιτρέπει το απαραίτητο αρχείο admin-ajax.php. Στο ίδιο αρχείο μπορεί να δηλώνεται και η θέση του XML Sitemap.
Η οδηγία Disallow περιορίζει την πρόσβαση του crawler σε ένα path. Δεν αποτελεί όμως μηχανισμό ασφαλείας και δεν σημαίνει απαραίτητα ότι η αντίστοιχη URL δεν θα εμφανιστεί ποτέ στη Google.
Το noindex ελέγχει το indexing
Το noindex έχει διαφορετικό σκοπό. Ζητά από τη μηχανή αναζήτησης να μην εμφανίσει μια σελίδα στα αποτελέσματα. Μπορεί να τοποθετηθεί σε ένα robots meta tag μέσα στο HTML ή να δοθεί μέσω HTTP header.
Η βασική διαφορά είναι απλή: το robots.txt αφορά κυρίως το crawling, ενώ το noindex αφορά το indexing. Το πρώτο λέει στη Google αν μπορεί να ζητήσει μια σελίδα. Το δεύτερο λέει αν πρέπει να την εμφανίσει στα αποτελέσματα.
Γιατί δεν πρέπει να συνδυάζονται τυχαία
Ένα συνηθισμένο λάθος είναι να τοποθετείται μια σελίδα σε noindex και ταυτόχρονα να μπλοκάρεται στο robots.txt. Με αυτόν τον τρόπο, όμως, η Google μπορεί να μην καταφέρει να επισκεφθεί τη σελίδα και να διαβάσει την οδηγία noindex.
Αν ο στόχος είναι να παραμείνει μια δημόσια σελίδα εκτός αποτελεσμάτων, συνήθως πρέπει να είναι προσβάσιμη για crawling, ώστε η Google να δει το noindex. Το robots.txt από μόνο του δεν είναι η σωστή λύση για deindexing μιας κανονικής HTML σελίδας.
Μπορεί μια blocked URL να εμφανιστεί στη Google;
Ναι, αυτό είναι πιθανό. Η Google μπορεί να ανακαλύψει μια URL από έναν σύνδεσμο σε άλλη σελίδα ή από κάποια εξωτερική πηγή, ακόμη και αν το robots.txt δεν της επιτρέπει να διαβάσει το περιεχόμενο. Σε ορισμένες περιπτώσεις, η διεύθυνση μπορεί να εμφανιστεί στα αποτελέσματα χωρίς κανονικό snippet.
Αν το περιεχόμενο είναι ιδιωτικό ή ευαίσθητο, ούτε το robots.txt ούτε το noindex προσφέρουν πραγματική προστασία. Για τέτοιες περιπτώσεις απαιτείται authentication, κωδικός πρόσβασης ή άλλος τεχνικός περιορισμός.
Προσοχή στο Disallow: /
Η οδηγία Disallow: / ζητά από τους crawlers να μην κάνουν crawl ολόκληρο το site. Μπορεί να είναι χρήσιμη σε περιβάλλον ανάπτυξης ή δοκιμών, αλλά γίνεται ιδιαίτερα επικίνδυνη αν παραμείνει ενεργή μετά τη δημοσίευση της ιστοσελίδας.
Μετά από migration, redesign ή μεταφορά από staging σε production, αξίζει να ελέγχεται πάντα το robots.txt. Ένας γενικός αποκλεισμός που ξεχάστηκε μπορεί να εμποδίσει τη Google να επισκεφθεί όλο το site.
Μην αποκλείεις CSS και JavaScript χωρίς λόγο
Το robots.txt μπορεί να περιορίσει όχι μόνο HTML σελίδες, αλλά και αρχεία CSS ή JavaScript. Αν αυτά τα αρχεία είναι απαραίτητα για τη σωστή εμφάνιση και λειτουργία μιας σελίδας, ο αποκλεισμός τους μπορεί να δυσκολέψει τη Google να δει το site όπως το βλέπει ο χρήστης.
Το γεγονός ότι ένας φάκελος δεν αποτελεί σελίδα που θέλεις να κατατάξεις δεν σημαίνει αυτόματα ότι πρέπει να μπει σε Disallow. Χρειάζεται να υπάρχει συγκεκριμένος λόγος για κάθε περιορισμό.
Τι προσφέρει το XML Sitemap
Το XML Sitemap λειτουργεί σαν οργανωμένος κατάλογος των σημαντικών URLs μιας ιστοσελίδας. Βοηθά τη Google να ανακαλύψει νέες ή ενημερωμένες σελίδες, ιδιαίτερα όταν το site είναι μεγάλο, καινούργιο, έχει λίγα εξωτερικά links ή περιλαμβάνει περιεχόμενο που δεν είναι εύκολο να βρεθεί μέσω της πλοήγησης.
Ωστόσο, η παρουσία μιας URL στο sitemap δεν εγγυάται ότι θα γίνει crawl, index ή ότι θα καταταχθεί ψηλά. Το sitemap βοηθά στην ανακάλυψη, δεν επιβάλλει την εμφάνιση μιας σελίδας στα αποτελέσματα.
Τι πρέπει να περιλαμβάνει ένα σωστό sitemap
Στο sitemap καλό είναι να υπάρχουν κυρίως οι URLs που θέλεις πραγματικά να είναι διαθέσιμες για indexing: σημαντικές σελίδες υπηρεσιών, landing pages και άρθρα που θέλεις να εμφανίζονται στην αναζήτηση.
Δεν χρειάζεται να περιλαμβάνονται σελίδες με noindex, redirects, duplicate παραλλαγές ή URLs που δεν είναι canonical. Σε WordPress με Yoast SEO, το sitemap index βρίσκεται συνήθως στη διεύθυνση /sitemap_index.xml και ενημερώνεται αυτόματα όταν αλλάζει το indexable περιεχόμενο.
Έλεγχος μέσα από το Google Search Console
Ο πρακτικός έλεγχος ξεκινά με το άνοιγμα του robots.txt στον browser. Στη συνέχεια, μπορείς να ελέγξεις αν το sitemap φορτώνει σωστά και να το υποβάλεις στην αναφορά Sitemaps του Google Search Console.
Για μεμονωμένες σελίδες, το εργαλείο URL Inspection δείχνει αν η Google μπορεί να τις επισκεφθεί, αν υπάρχουν προβλήματα indexing και αν κάποιο noindex ή canonical επηρεάζει την εμφάνισή τους.
Η σωστή βάση για ένα μικρό WordPress site
Σε μια μικρή επαγγελματική ιστοσελίδα δεν χρειάζεται περίπλοκο robots.txt ή υπερβολική ενασχόληση με το crawl budget. Προτεραιότητα έχουν οι crawlable σημαντικές σελίδες, η απουσία κατά λάθος site-wide noindex ή Disallow, το καθαρό sitemap και η σωστή εσωτερική σύνδεση.
Το robots.txt δεν ανεβάζει μόνο του μια ιστοσελίδα στη Google. Επιτρέπει όμως στις μηχανές αναζήτησης να ανακαλύψουν και να επεξεργαστούν σωστά το περιεχόμενο. Γνώριζες τη διαφορά ανάμεσα σε crawling, indexing και sitemap; Αν βρήκες το κείμενο χρήσιμο, μπορείς να το μοιραστείς και να περιηγηθείς στην ιστοσελίδα για περισσότερα σχετικά άρθρα γύρω από το SEO και την κατασκευή ιστοσελίδων.