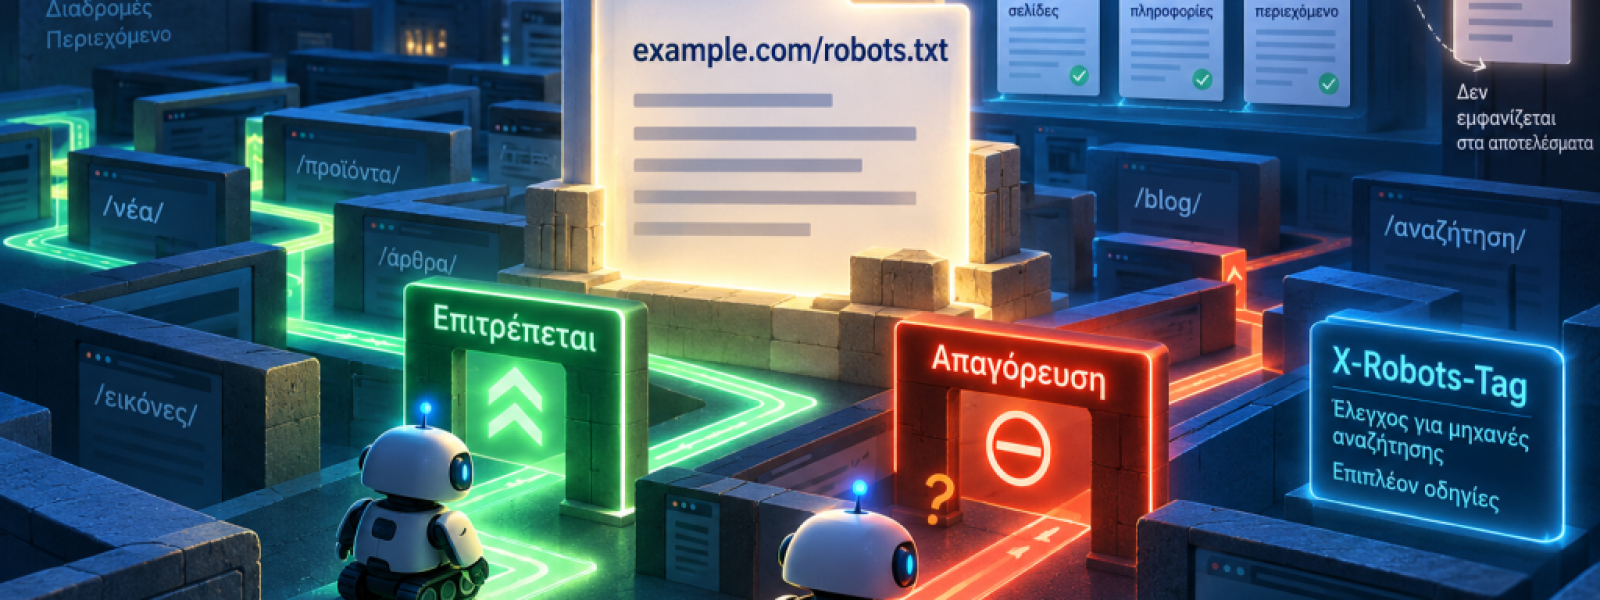
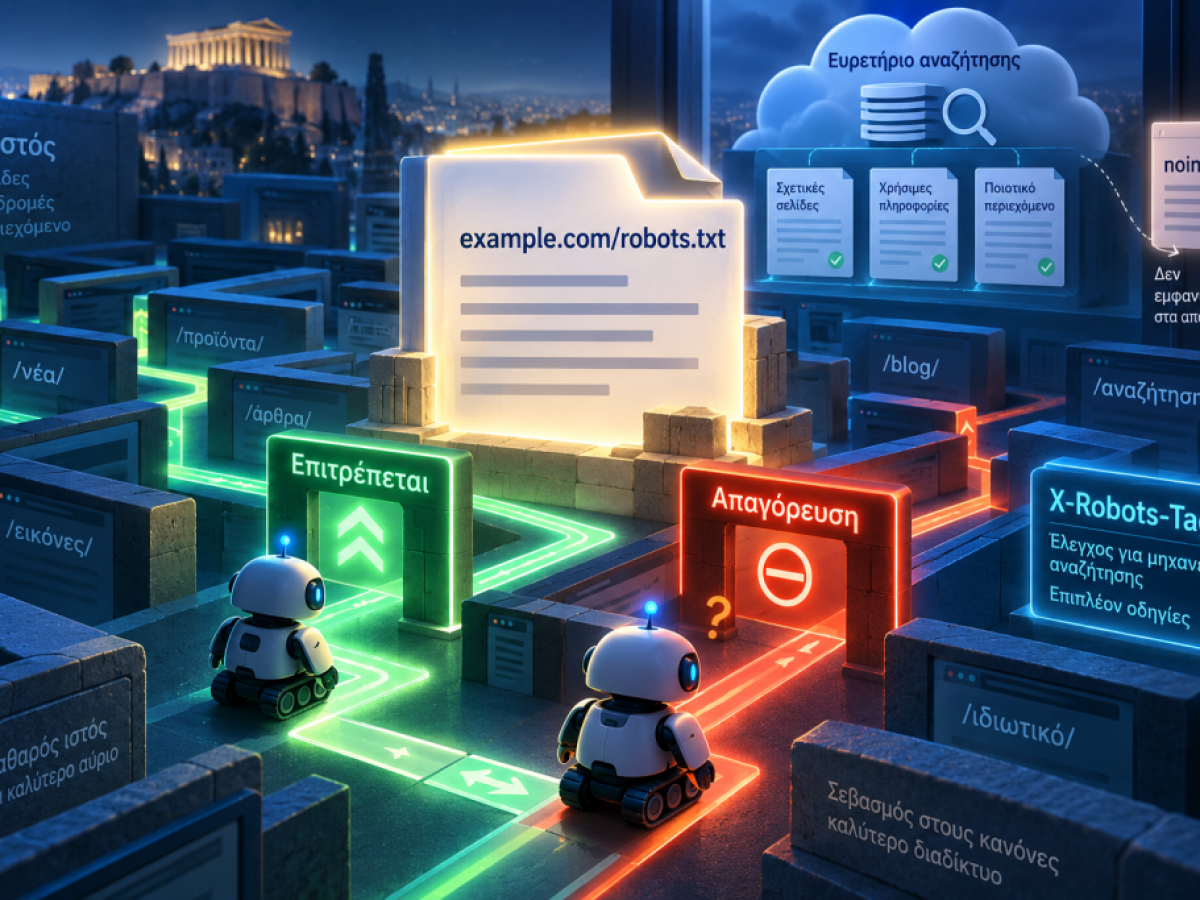
Όταν δημιουργείτε έναν ιστότοπο, πιθανότατα θέλετε οι σελίδες του να εμφανίζονται στα αποτελέσματα του Google Search. Υπάρχουν όμως περιπτώσεις όπου δεν επιθυμείτε να εμφανίζεται μια συγκεκριμένη σελίδα ή δεν θέλετε το Googlebot να αφιερώνει χρόνο στην ανίχνευση ορισμένων διευθύνσεων. Για τον σκοπό αυτό υπάρχουν δύο βασικά εργαλεία: το robots meta tag και το αρχείο robots.txt. Παρότι συχνά συγχέονται, χρησιμοποιούνται για διαφορετικές ανάγκες.
Το robots meta tag ελέγχει την ευρετηρίαση
Το robots meta tag είναι ένα στοιχείο HTML που προστίθεται στην ενότητα <head> μιας σελίδας. Με αυτό μπορείτε να δώσετε οδηγίες σχετικά με το αν η σελίδα θα πρέπει να καταχωριστεί στο ευρετήριο του Google Search.
Η πιο απλή οδηγία είναι το noindex. Όταν χρησιμοποιείται, ζητά από το Google να μην προσθέσει τη συγκεκριμένη σελίδα στα αποτελέσματα αναζήτησης. Η οδηγία μπορεί επίσης να απευθύνεται σε συγκεκριμένα bots. Για παράδειγμα, μπορεί να επιτρέπετε την ευρετηρίαση από το Googlebot, αλλά να ζητάτε από το Googlebot-News να μην καταχωρίσει τη σελίδα.
Στο ίδιο tag μπορούν να προστεθούν και άλλες οδηγίες. Μπορείτε, για παράδειγμα, να ζητήσετε να μην εμφανίζονται snippets ή να μην προσφέρονται μεταφράσεις της σελίδας μέσα στα αποτελέσματα αναζήτησης.
Η εναλλακτική λύση με HTTP header
Αντί για meta tag, οι ίδιες οδηγίες μπορούν να σταλούν μέσω ενός HTTP header που ονομάζεται X-Robots-Tag. Η λειτουργία του είναι αντίστοιχη με εκείνη του robots meta tag, αλλά εφαρμόζεται σε επίπεδο απόκρισης του διακομιστή.
Αυτή η επιλογή μπορεί να είναι χρήσιμη όταν θέλετε να ελέγξετε περιεχόμενο που δεν είναι τυπική HTML σελίδα ή όταν οι οδηγίες πρέπει να ρυθμιστούν από τον διακομιστή. Και στις δύο περιπτώσεις, το βασικό μήνυμα είναι το ίδιο: η σελίδα μπορεί να προσπελαστεί, αλλά δεν πρέπει απαραίτητα να εμφανιστεί στο ευρετήριο.
Τι είναι το robots.txt
Το robots.txt είναι ένα απλό αρχείο κειμένου που περιέχει κανόνες για τα bots. Βρίσκεται στη ρίζα του domain, όπως στη διεύθυνση:
example.com/robots.txt
Δεν λειτουργεί αν τοποθετηθεί σε έναν υποφάκελο, όπως:
example.com/products/robots.txt
Για websites με subdomains, κάθε subdomain μπορεί να έχει το δικό του αρχείο. Έτσι, το shop.example.com μπορεί να χρησιμοποιεί το shop.example.com/robots.txt.
Αν χρησιμοποιείτε website builder ή Content Management System, είναι πιθανό να υπάρχει plugin, σχετική ρύθμιση ή ξεχωριστή λειτουργία για τη διαχείριση του αρχείου.
Κανόνες allow και disallow
Το robots.txt περιλαμβάνει κανόνες που επιτρέπουν ή απαγορεύουν την πρόσβαση σε URL και μοτίβα URL. Ένας κανόνας Disallow μπορεί να εμποδίσει την ανίχνευση μιας συγκεκριμένης διαδρομής από τα bots που ακολουθούν το πρότυπο του robots.txt.
Για παράδειγμα, μπορείτε να αποκλείσετε όλες τις διευθύνσεις που ξεκινούν από μια συγκεκριμένη διαδρομή. Μπορείτε επίσης να δώσετε διαφορετικές οδηγίες σε διαφορετικά bots, χρησιμοποιώντας το όνομα του user agent τους. Σε ένα παράδειγμα, ένας bot που ονομάζεται Stevebot μπορεί να αποκτήσει πρόσβαση σε έναν φάκελο που έχει αποκλειστεί για τα υπόλοιπα bots.
Ο χαρακτήρας * λειτουργεί ως wildcard και κάνει τους κανόνες πιο σύντομους. Ωστόσο, πρέπει να θυμάστε ότι δεν ακολουθούν όλα τα bots τις οδηγίες του robots.txt. Το Googlebot και οι περισσότερες μεγάλες μηχανές αναζήτησης συνήθως τις τηρούν.
Προσθέστε και το sitemap
Το robots.txt μπορεί να χρησιμοποιηθεί και για να υποδείξει τη θέση του sitemap του website. Με την οδηγία Sitemap μπορείτε να ενημερώσετε τα bots για τη διεύθυνση του αρχείου που περιγράφει τις σημαντικές σελίδες του ιστοτόπου.
Αυτό δεν αντικαθιστά άλλες μεθόδους ενημέρωσης των μηχανών αναζήτησης, αλλά προσφέρει ένα επιπλέον, σαφές σημείο αναφοράς για την ανακάλυψη του sitemap.
Η συχνότερη παρεξήγηση
Ένα σημαντικό σημείο είναι ότι το robots.txt δεν είναι ο σωστός τρόπος για να αποτρέψετε μια σελίδα από την εμφάνιση στο Google Search. Αν μια σελίδα αποκλειστεί στο robots.txt, το Googlebot δεν μπορεί να την επισκεφθεί και επομένως δεν μπορεί να διαβάσει το robots meta tag ή το X-Robots-Tag.
Το Googlebot μπορεί, ωστόσο, να ανακαλύψει έναν σύνδεσμο προς αυτή τη σελίδα από άλλο σημείο. Έτσι, μπορεί να γνωρίζει ότι η σελίδα υπάρχει, χωρίς να βλέπει το περιεχόμενό της. Σε ορισμένες περιπτώσεις, η σελίδα μπορεί να εμφανιστεί στο ευρετήριο με περιορισμένες πληροφορίες.
Αν ο στόχος σας είναι να μην καταχωριστεί μια σελίδα, χρησιμοποιήστε noindex μέσω robots meta tag ή X-Robots-Tag και μην την αποκλείσετε ταυτόχρονα στο robots.txt. Το Googlebot πρέπει να μπορεί να προσπελάσει τη σελίδα ώστε να διαβάσει την οδηγία.
Πώς να ελέγξετε τις ρυθμίσεις
Το Google Search Console διαθέτει αναφορά για το robots.txt, ώστε να δείτε πώς επηρεάζουν οι κανόνες την ανίχνευση του website. Μπορείτε επίσης να χρησιμοποιήσετε ένα open-source robots.txt tester για να ελέγξετε αν μια συγκεκριμένη διεύθυνση επιτρέπεται ή αποκλείεται.
Η σωστή διάκριση είναι απλή: το robots.txt ελέγχει την ανίχνευση, ενώ το robots meta tag και το X-Robots-Tag ελέγχουν κυρίως την ευρετηρίαση και τον τρόπο εμφάνισης μιας σελίδας. Γνωρίζοντας αυτή τη διαφορά, μπορείτε να αποφεύγετε συνηθισμένα λάθη στο Technical SEO.
Γνωρίζατε αυτή τη διαφορά; Αν βρήκατε το άρθρο ενδιαφέρον, μπορείτε να το μοιραστείτε και να περιηγηθείτε στην ιστοσελίδα για περισσότερα σχετικά άρθρα.