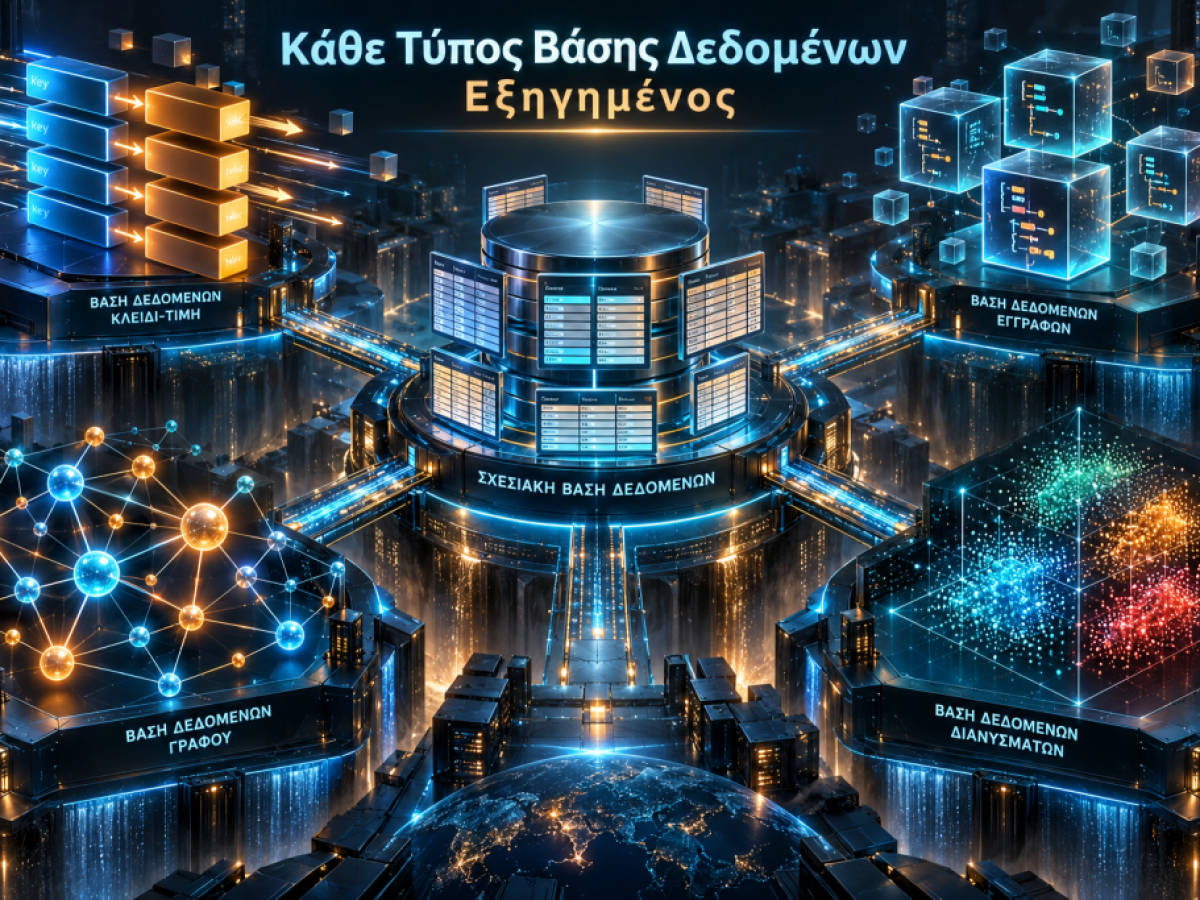
Οι βάσεις δεδομένων δεν είναι όλες ίδιες. Υπάρχουν περισσότερες από 400 διαθέσιμες επιλογές, όμως κάθε τύπος έχει δημιουργηθεί για να λύνει ένα διαφορετικό πρόβλημα. Η σωστή επιλογή εξαρτάται από το είδος των δεδομένων, τον όγκο τους, την ταχύτητα που απαιτείται και τον τρόπο με τον οποίο θα τα αναζητούν οι χρήστες. Στις περισσότερες περιπτώσεις, η καλύτερη αρχή είναι πιο απλή απ’ όσο φαίνεται.
Σχεσιακές βάσεις δεδομένων
Οι σχεσιακές βάσεις αποθηκεύουν τα δεδομένα σε πίνακες με γραμμές και στήλες. Χρησιμοποιούν SQL και επιβάλλουν σαφή δομή, τύπους δεδομένων και σχέσεις μεταξύ εγγραφών. Οι MySQL, PostgreSQL, Oracle και SQL Server είναι χαρακτηριστικά παραδείγματα.
Αποτελούν εξαιρετική επιλογή για ηλεκτρονικά καταστήματα, οικονομικές εφαρμογές και γενικά συστήματα όπου η συνέπεια των δεδομένων έχει μεγαλύτερη σημασία από την απόλυτη ταχύτητα. Παρά την άνοδο των NoSQL βάσεων, μια σωστά ρυθμισμένη σχεσιακή βάση μπορεί να εξυπηρετήσει τεράστιο όγκο χρηστών. Η PostgreSQL, για παράδειγμα, χρησιμοποιείται σε εφαρμογές μεγάλης κλίμακας, όπως το Instagram.
Βάσεις τύπου key-value
Οι key-value βάσεις είναι οι πιο απλές: κάθε τιμή αποθηκεύεται μαζί με ένα μοναδικό κλειδί. Όταν χρειάζεστε μια συγκεκριμένη τιμή, αναζητάτε το κλειδί της και την παίρνετε σχεδόν αμέσως. Οι Redis, Amazon DynamoDB και Memcached ανήκουν σε αυτή την κατηγορία.
Το βασικό τους πλεονέκτημα είναι η πολύ χαμηλή καθυστέρηση. Χρησιμοποιούνται για προσωρινή αποθήκευση, συνεδρίες χρηστών, μετρητές σε πραγματικό χρόνο και πίνακες κατάταξης. Δεν είναι όμως κατάλληλες για σύνθετες αναζητήσεις. Είναι ένα ακριβές εργαλείο για συγκεκριμένη δουλειά, όχι αντικατάσταση μιας πλήρους σχεσιακής βάσης.
Βάσεις εγγράφων
Οι βάσεις εγγράφων αποθηκεύουν τις πληροφορίες σε έγγραφα JSON ή BSON. Κάθε έγγραφο μπορεί να έχει διαφορετικά πεδία, γεγονός που προσφέρει μεγάλη ευελιξία όταν η δομή των δεδομένων αλλάζει συχνά. Η MongoDB είναι το πιο γνωστό παράδειγμα, ενώ σημαντικές επιλογές είναι επίσης οι CouchDB και Firestore.
Ταιριάζουν σε προφίλ χρηστών, καταλόγους προϊόντων και συστήματα διαχείρισης περιεχομένου. Ωστόσο, η απουσία αυστηρού σχήματος δεν σημαίνει απουσία σχεδιασμού. Χωρίς σωστή οργάνωση, η ευελιξία μπορεί γρήγορα να μετατραπεί σε ακατάστατα δεδομένα και δύσκολες αναζητήσεις.
Wide-column βάσεις
Οι wide-column βάσεις έχουν γραμμές και στήλες, αλλά κάθε γραμμή μπορεί να περιέχει διαφορετικές στήλες. Είναι σχεδιασμένες για οριζόντια κλιμάκωση: αντί να αγοράζετε έναν ισχυρότερο διακομιστή, προσθέτετε περισσότερους διακομιστές.
Η Apache Cassandra είναι η πιο γνωστή επιλογή και χρησιμοποιείται σε συστήματα με τεράστιο όγκο δεδομένων, όπως τηλεμετρία από συσκευές, καταγραφή γεγονότων και πλατφόρμες ανταλλαγής μηνυμάτων. Αν όμως τα δεδομένα σας χωρούν άνετα σε έναν διακομιστή, η πολυπλοκότητα αυτής της λύσης πιθανότατα δεν αξίζει τον κόπο.
Graph βάσεις
Οι graph βάσεις οργανώνουν τα δεδομένα ως κόμβους και ακμές. Οι κόμβοι αντιπροσωπεύουν οντότητες, ενώ οι ακμές τις σχέσεις τους. Η Neo4j, η Amazon Neptune και η ArangoDB χρησιμοποιούνται όταν το σημαντικότερο στοιχείο είναι το πώς συνδέονται μεταξύ τους τα δεδομένα.
Είναι χρήσιμες σε κοινωνικά δίκτυα, συστήματα ανίχνευσης απάτης, μηχανές προτάσεων και knowledge graphs. Αν το βασικό ερώτημα είναι «με ποιον τρόπο συνδέεται αυτό με εκείνο;», μια graph βάση μπορεί να είναι πολύ πιο αποτελεσματική από μια αλυσίδα σύνθετων SQL JOIN.
Time series και search βάσεις
Οι time series βάσεις είναι φτιαγμένες για δεδομένα που καταφθάνουν με χρονολογική σειρά, όπως μετρήσεις αισθητήρων, τιμές μετοχών και δεδομένα παρακολούθησης διακομιστών. Οι InfluxDB, TimescaleDB και Prometheus προσφέρουν υψηλή ταχύτητα εγγραφών, συμπίεση και πολιτικές διατήρησης δεδομένων.
Οι search βάσεις, όπως η Elasticsearch, έχουν διαφορετικό στόχο: κάνουν την αναζήτηση πλήρους κειμένου γρήγορη και σχετική. Χρησιμοποιούνται σε ιστοτόπους, ηλεκτρονικά καταστήματα και ανάλυση αρχείων καταγραφής. Δεν πρέπει όμως να αντιμετωπίζονται ως κύρια βάση δεδομένων, επειδή δίνουν προτεραιότητα στις αναζητήσεις και όχι στην αυστηρή συνέπεια των εγγραφών.
In-memory και vector βάσεις
Οι in-memory βάσεις αποθηκεύουν τα δεδομένα στη RAM, προσφέροντας εξαιρετικά γρήγορη πρόσβαση. Η Redis χρησιμοποιείται για cache, συνεδρίες, καλάθια αγορών και δεδομένα πραγματικού χρόνου. Οι σύγχρονες λύσεις υποστηρίζουν επίσης μόνιμη αποθήκευση, επομένως δεν χάνονται υποχρεωτικά όλα τα δεδομένα μετά από επανεκκίνηση.
Οι vector βάσεις αποθηκεύουν αριθμητικές αναπαραστάσεις κειμένων, εικόνων ή ήχων. Οι Pinecone, Weaviate, Milvus και Chroma χρησιμοποιούνται για αναζήτηση ομοιότητας, σημασιολογική αναζήτηση και εφαρμογές τεχνητής νοημοσύνης. Για μέτριες ανάγκες, όμως, η PostgreSQL με την επέκταση pgvector μπορεί να είναι αρκετή.
NewSQL, object-oriented και embedded βάσεις
Οι NewSQL βάσεις, όπως οι Google Spanner, CockroachDB και TiDB, συνδυάζουν τη συνέπεια και το SQL των σχεσιακών βάσεων με οριζόντια κλιμάκωση. Είναι κατάλληλες για παγκόσμιες εφαρμογές, τραπεζικά συστήματα και αποθέματα όπου ένα λάθος δεδομένο μπορεί να δημιουργήσει σοβαρό πρόβλημα.
Οι object-oriented βάσεις αποθηκεύουν αντικείμενα όπως ακριβώς υπάρχουν στον κώδικα. Παραμένουν χρήσιμες σε ορισμένους εξειδικευμένους κλάδους, αλλά σπάνια αποτελούν την πρώτη επιλογή για ένα νέο έργο. Αντίθετα, οι embedded βάσεις, με κορυφαίο παράδειγμα τη SQLite, λειτουργούν μέσα στην ίδια την εφαρμογή. Δεν χρειάζονται ξεχωριστό διακομιστή και είναι ιδανικές για κινητά, επιτραπέζιες εφαρμογές, συσκευές IoT και πρωτότυπα.
Η σωστή επιλογή
Δεν υπάρχει μία βάση δεδομένων που να είναι καλύτερη για όλα. Η επιλογή πρέπει να ξεκινά από το πραγματικό πρόβλημα: χρειάζεστε συνέπεια, ταχύτητα, αναζήτηση κειμένου, σχέσεις, τεράστια κλιμάκωση ή λειτουργία χωρίς διακομιστή; Συνήθως, η πιο συνετή προσέγγιση είναι να ξεκινήσετε με μια αξιόπιστη σχεσιακή βάση και να προσθέσετε εξειδικευμένα εργαλεία μόνο όταν οι ανάγκες σας το απαιτήσουν.
Γνωρίζατε αυτές τις διαφορές ή σας φάνηκε χρήσιμο το άρθρο; Αν σας άρεσε, μπορείτε να το μοιραστείτε και να περιηγηθείτε στην ιστοσελίδα για περισσότερα σχετικά άρθρα.